为什么选择离线语音合成
在线 TTS 把文本发到云端才能开口;Lovo 反过来——模型住在你的机器上,随叫随到。
隐私与数据安全
在线 TTS 需要把文本发到云端,医疗、金融、企业内部文档、未公开内容就不太适合上传。离线 TTS 全程本地推理,文本不出设备,更适合敏感场景。
ZERO CLOUD UPLOAD成本可控
云端 TTS 多按字符、时长或调用次数计费,批量配音、长期高频使用时成本会累积。离线 TTS 模型一次性部署后,后续使用基本没有持续调用费。
ONE-TIME DEPLOY可集成、可自动化
提供 CLI、HTTP API、桌面 UI,方便接入视频配音、批量生成、工作流自动化。比如批量生成旁白、为 ComfyUI 工作流提供音频输出,或做成内部配音服务。
CLI · API · GUI| 在线 TTS 服务 | Lovo(离线) | |
|---|---|---|
| 数据流向 | 文本上传云端,依赖供应商合规 | 文本与音频全程本地,不出设备 |
| 计费方式 | 按字符 / 时长 / 调用次数持续计费 | 一次部署,无限次调用零费用 |
| 集成方式 | 网络 SDK,受网络与限流约束 | CLI / 本地 HTTP API / 桌面 UI,进程内零延迟 |
| 断网可用 | 依赖网络连通性 | 完全可用,内网/隔离环境同样部署 |
主要功能特性
一个工具箱覆盖从"念稿子"到"克隆你的声音"再到"开放成服务"的完整链路。
声音克隆
一段参考音频提取声纹,驱动任意新文本;支持 ICL 参考文本与 x-vector 两种模式。
clone --reference9 个预设音色
CustomVoice 内置男女声与中英韩日风格:vivian、ryan、serena、sohee……一行参数切换。
--speaker vivian音色设计
VoiceDesign 模型用一句话文字描述,即生成全新的目标音色,无需任何参考音频;也可用 CLI 的 design 子命令驱动。
design --instruct多语言
中文、英文多语言输出,并提供日韩特色说话人(sohee / ono_anna),适配出海内容与多语种旁白需求。
--language长文本自动分段
超过 max-chars 的文本智能切分逐段合成再拼接,小说级长文、整章旁白直接喂入。
--max-chars 200音频脚本生成
桌面端调用大模型把小说文本改写成带 [角色:情绪] 标记的 TTS 脚本,一键质检格式、角色统一与情绪标注。
AI 脚本 · 检查多角色剧本合成
识别文本中的角色标记,按行解析、相邻同角色行合并成组,多角色台词拼接进同一个 WAV,有声书制作不再逐段手动切。
[角色:情绪]插入音效标记
朗读文本里写一行 <音效:敲门声>,合成时自动把对应音效拼进主轨;<停顿:1.5> 还能插入静音。标记可出现在任意位置、不占字数额度,音效找不到则静默跳过,音效库在桌面端本地管理。
<音效:名称>实时播放波形
朗读试听时 48 频带频谱竖条随声跳动,音频能量与播放状态一目了然,不落盘即听即验。
48-BAND WAVE声音角色库
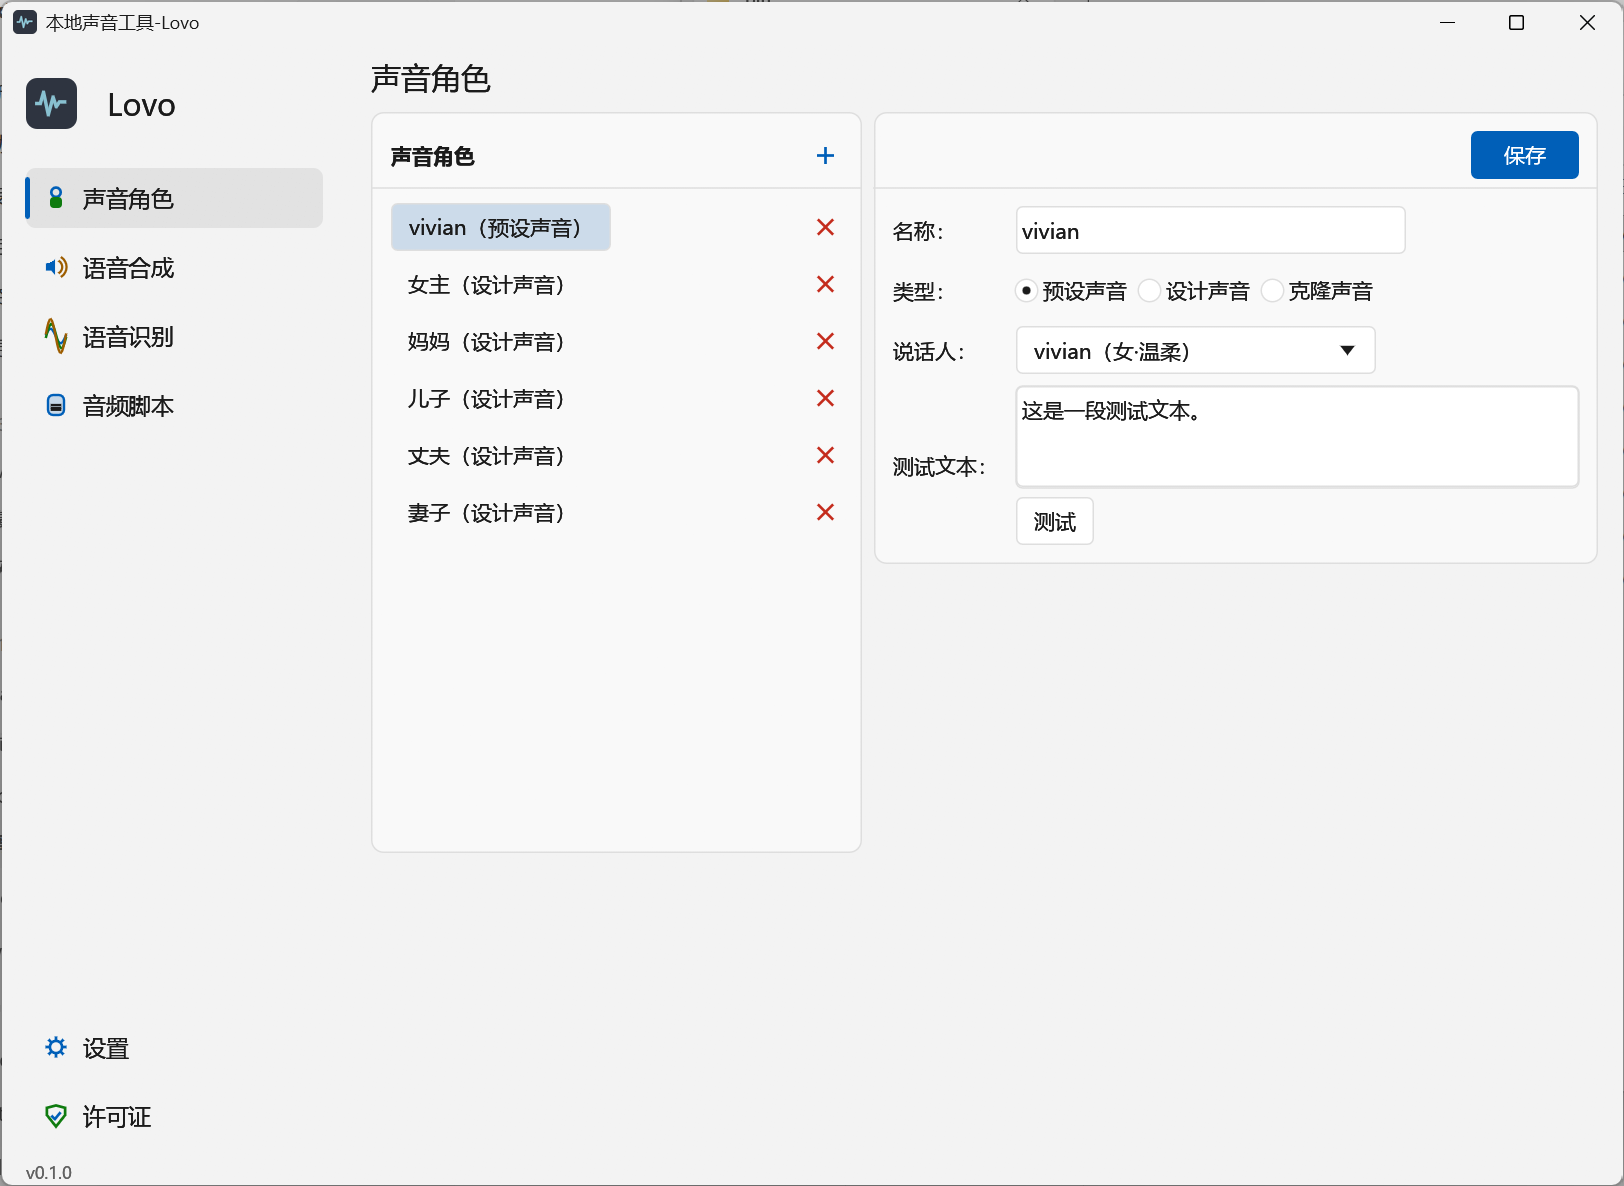
预设 / 设计 / 克隆角色本地统一管理,新增、编辑、删除即点即存;每条角色可配测试文本,一键试听。
SQLite · 本地设备自动选择
单一二进制,运行时优先 CUDA、不可用自动回退 CPU,无需区分构建版本。
CUDA → CPUOpenAI 兼容 API
POST /v1/audio/speech 请求体与官方一致,现有集成改个 base_url 即可指向本地。
:8000/v1/audio/speech采样与输出可控
贪心 / temperature 采样调节,WAV 输出;API 支持 8–96 kHz 采样率重采样。
--greedy / --temperature语音识别 (ASR)
Qwen3-ASR 将音频转写为文本,自动检测语言,也可强制指定语言与自定义最大 token。
asr --audio逐句时间轴
语音识别勾选「显示时间戳」,叠加 Qwen3-ForcedAligner 做字符级强制对齐,输出带起止时间的逐句分段文本 [0.00s - 3.20s] 文本,字幕、剪辑逐句对齐一步到位。
显示时间戳轻量部署
Rust 单二进制,无需安装 Python 环境;最低 8GB 显存 NVIDIA 显卡(CUDA)即可流畅运行,CPU 模式同样支持。
8GB VRAM · CPU三步做完一部音频小说
从一段小说原文到成品 WAV:AI 改写脚本 → 建好角色声音 → 一次合成对话音频。角色名与情绪全程离线推断,不上传原文。
生成音频脚本
把小说原文粘进「音频脚本」页,点「生成脚本」——AI 自动区分旁白与对话、标注角色情绪,输出标准 TTS 脚本;「检查」按钮可再按规则质检一遍。
碗洗完了。你今天怎么没把锅泡上?”丈夫靠在门框上问。
“我回来就忙着改方案,你又不是不知道。”妻子头也不抬地应了一句。
丈夫无奈地笑了笑:“知道知道,你们组最近忙得跟打仗一样。”
“别提了,客户下午又改需求。”妻子叹气说,“我感觉自己像个人形备忘录。”
“那周末还去爸妈家吗?”丈夫试探着问。
“去啊,不是说好带宝宝回去的吗?”妻子瞪了他一眼,“你不会又想临时加班吧?”
丈夫心虚地摸了摸鼻子:“我尽量不加……但周五那个会还没定时间。”
“陈屿,”妻子眯起眼睛,“你上次说‘尽量’的时候,结果在办公室睡了一夜。”
[丈夫:平和] 碗洗完了。你今天怎么没把锅泡上?
[妻子:疲惫] 我回来就忙着改方案,你又不是不知道。
[丈夫:无奈] 知道知道,你们组最近忙得跟打仗一样。
[妻子:抱怨] 别提了,客户下午又改需求。我感觉自己像个人形备忘录。
[丈夫:试探] 那周末还去爸妈家吗?
[妻子:怀疑] 去啊,不是说好带宝宝回去的吗?你不会又想临时加班吧?
[丈夫:心虚] 我尽量不加……但周五那个会还没定时间。
[妻子:警告] 陈屿,你上次说“尽量”的时候,结果在办公室睡了一夜。
增加声音角色:丈夫、妻子
在「声音角色」页新增两条角色,一句话描述音色即可(也可用参考音频克隆)。每条角色都能填「测试文本」先试听,满意再保存。
名称:丈夫
类型:设计声音
音色描述:沉稳、温和的成年男声,语速自然,略带书卷气
名称:妻子
类型:设计声音
音色描述:温和、聪慧的成年女声,语调轻快、咬字清晰
语音合成:生成夫妻对话.wav
把脚本粘进「语音合成」页点「开始合成」。脚本里的 [角色:情绪] 标记会被逐行识别、自动匹配对应声音,相邻同角色台词合并成连续朗读,最终写入一个完整 WAV。
输出文件:output\夫妻对话.wav
格式:WAV 24 kHz · 8 段对话 · 分段不跨行
角色名需与「声音角色」页一致,否则该行报找不到角色;
情绪会拼进音色指令,让语气自然不夸张;
想先听效果,用「朗读」不落盘试听(带实时波形)。
18 秒看懂 Lovo
产品速览:本地推理、声音克隆、音色设计与桌面端一键出声。
时长 18 秒 · 含背景音乐 · 各项能力详见上方版块介绍
给 AI 助手的语音技能包
Lovo-skill 把 voice-cli 封装成技能包:在 Doubao 等 AI 助手的对话里,一句话就能触发语音合成、声音克隆、音色设计与语音识别,文本全程不出设备。
voice-cli(AI 助手可调用)
  ├─ synth   语音合成   --model-path <TTS> --text ... --speaker vivian
  ├─ clone   声音克隆   --reference ref.wav --text ... [--ref-text ref.txt]
  ├─ design  音色设计   --instruct "年轻女性,甜美温柔" --text ...
  └─ asr     语音识别   --audio input.wav [--language chinese]

全局:--model-path 必填;--max-chars 分段(默认 200)
许可:启动先校验 license.dat,未授权不执行
输出:合成/克隆/设计 WAV(24kHz),识别 TXT
用法示意 —— 对 AI 助手说"用 vivian 的声音朗读这段文案",助手即调用 synth,返回 output.wav。
bin/       voice-cli.exe · license.dat
models/    Qwen3-TTS-12Hz-1.7B-{Base,CustomVoice,VoiceDesign}
           Qwen3-ASR-<size>(含 tokenizer.json)
voices/    <voice-name>/voice-ref.wav + voice-ref.txt
9 个预设音色(CustomVoice)—— vivian、ryan、dylan、aiden、serena、eric、uncle_fu、sohee(韩)、ono_anna(日)。
简单透明的定价
免费版永久可用,先试用再决定;Pro 一次性买断,无订阅、无年度续费。
免费版
适合试用体验
- 合成 / 克隆 / 音色设计 / 识别 全功能可用
- 输入或输出文本长度不超过 50 个字符
- 全程本地推理,数据不出设备
- 不支持长文本与后续软件升级(升级 Pro 解锁)
Pro 版
一次买断,长期使用
- 无功能限制,文本长度不限
- 包含后续软件升级
- CLI / HTTP API / 桌面 UI 全形态解锁
- 激活文件离线校验,无需联网
免费版无需激活即可使用;购买 Pro 后把 license.dat 放到程序目录即可解锁全部功能。